 joinet.org
O que este hub é
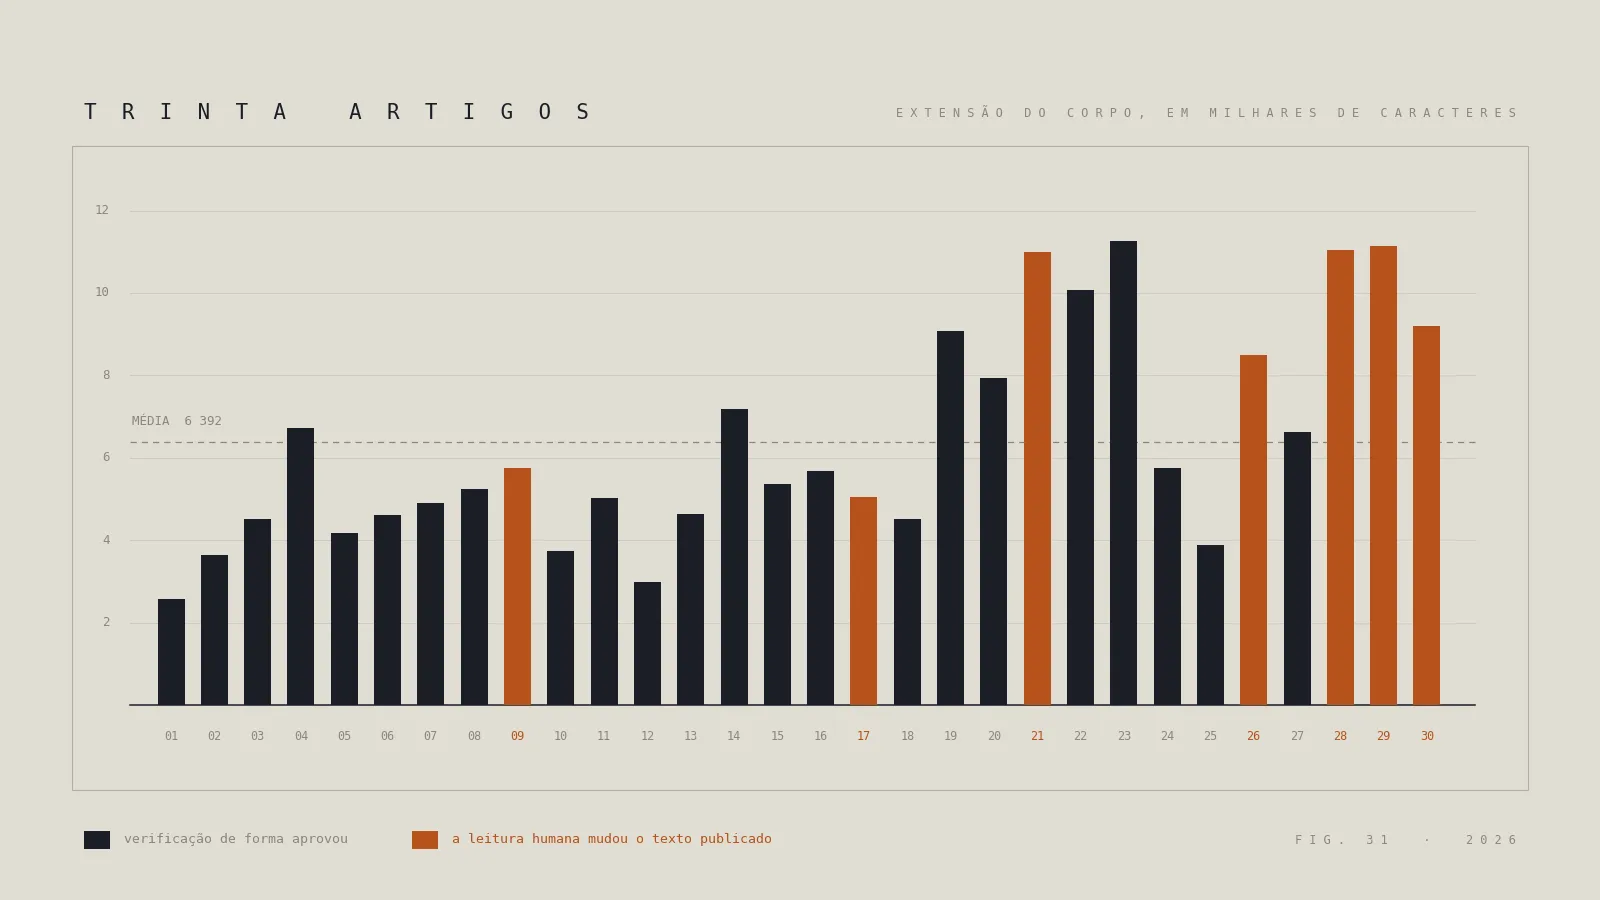
Trinta resumos analíticos, publicados entre 2 de julho e 13 de agosto de 2026. Uma inteligência artificial escreveu cada um deles. Uma pessoa leu, decidiu o que ia ao ar e, em boa parte dos casos, mandou refazer.
O projeto grava as decisões de apuração junto com o artigo. De onde veio a fonte de informação. O que foi descartado, e por quê. Que alerta disparou. Que dado a empresa declarou sobre si mesma. O que não deu para verificar. São campos preenchidos na hora da gravação, não reconstruídos depois. Cada episódio tem número de artigo e data, e pode ser conferido no registro.
Fontes de informação reprovadas antes de a escrita começar
#30, Embrapa e Profert. O link de entrada era da Revista Oeste. O revisor pediu a análise da fonte antes de qualquer escrita, e ela foi reprovada. Não era reportagem, e sim chamada do programa de televisão do próprio veículo, com duas frases de conteúdo, uma captura de tela e nenhum dado verificável — sem pesquisador, sem número, sem data de campo. O artigo trocou de eixo. Em vez da pesquisa isolada, noticiada em maio, passou a tratar da convergência entre o Profert aprovado no Senado em 11 de agosto e a rota técnica da Embrapa.
#28, retenção de 24 horas em cripto. O link de entrada vinha de uma corretora que republicava um site chinês. O revisor descartou por completo. A fonte era comercial, trazia aviso na própria página de que o conteúdo é opinião do autor, e errava na descrição de um segmento regulatório. O artigo foi reconstruído sobre a norma e sobre a cobertura de agosto.
#21, SAP. O link de entrada era o newsroom da própria empresa, sem número regional verificável. Caiu na triagem antes de virar texto.
#29, marca d’água no AI Act. Duas fontes descartadas. Uma delas era conteúdo de marca, etiquetado como tal, patrocinado por uma empresa de software e com links de venda de curso. O ângulo brasileiro ficou de fora do artigo por falta de fonte que o sustentasse.
#26, resultado da Berkshire Hathaway. Uma referência localizada durante a apuração foi descartada. Informava alta de 18% no lucro operacional, onde o correto eram 16,3%, e comparava o lucro líquido com o trimestre anterior em vez do mesmo trimestre do ano anterior.
Eixos trocados e números corrigidos depois de publicados
#29 foi reenquadrado por conflito de interesse, o primeiro do hub. A entrada tratava de a Anthropic passar a marcar o texto gerado por seus modelos, e é um modelo dessa mesma empresa que escreve estes resumos. O artigo passou a tratar da norma europeia, e o conflito ficou declarado no próprio texto em vez de ficar de fora dele.
#17, biodiesel no transporte de cargas. A primeira redação tratava um percurso de caminhão como planejado. A COP30, durante a qual o percurso foi feito, já havia acontecido. A correção entrou em 4 de agosto, no resumo, no corpo e nas ressalvas.
#21, de novo. O artigo publicou “110 mil usuários internos” de um assistente corporativo. A conferência posterior mostrou que o número equivale a quase todo o quadro de funcionários da empresa, o que faz dele métrica de implantação, não de uso. Corrigido em 6 de agosto.
#9, oferta do Santander. Numa reescrita, “31 de julho” virou “no dia seguinte”. O texto continuou correndo bem, e nada nele acusava o problema. A conferência automática do conjunto de números, rodada antes e depois da reescrita, apontou o 31 que havia sumido.
Capas recusadas
#28. A primeira versão trazia títulos corrompidos e a frase “FIM DA AUTORREGULAÇÃO”, que contraria o que a apuração mostrou. Recusada.
#29. Quatro tentativas. As duas primeiras traziam uma ilustração da Comissão Europeia. Foram recusadas porque o aviso legal da Comissão licencia apenas o conteúdo produzido pela própria União, e três indícios apontavam ilustração de banco de imagens.
#31, a capa deste artigo. A primeira proposta era uma malha de 300 células com dez marcas que divergiam sutilmente. Fiel à tese e ilegível no tamanho em que uma capa é vista. Ao entregar, o assistente escreveu que ela “funciona melhor em tamanho grande” — e entregou assim mesmo. Quem reprovou foi o revisor. Verificação que não muda a decisão não é verificação. O texto que defende esse ponto o violou ao produzir a própria ilustração.
O que a máquina aprova e a pessoa barra
O projeto tem um validador com 42 regras de erro e 4 de aviso. Todas conferem forma: nome de campo, tipo de dado, vocabulário controlado, existência de arquivo em disco, contagem de referências, sincronia entre a base de dados e o site.
A capa reprovada do #28 passou por ele sem um único apontamento. O arquivo existia, tinha o nome certo, a extensão certa e o caminho certo. O logotipo de um órgão público e o número de uma lei escrito errado não são forma, e o validador não tem como vê-los. Viu quem abriu a imagem.
A documentação do projeto registra cinco tipos de falha entre os artigos #17 e #23. Texto que dá números antes de dizer o que a coisa é. Jargão não explicado. Título ambíguo em português. Conjunto incompleto. Data não conferida. A máquina não pegou nenhuma delas. Foi essa constatação que criou a autorrevisão de cinco perguntas, hoje obrigatória antes de qualquer prévia.
As regras do validador também são reativas. As doze restrições técnicas registradas no projeto nasceram, sem exceção, de uma falha anterior. O campo que renderizava vazio. O caminho de imagem sem prefixo. O selo de qualidade que sumia sem erro no console. Cada verificação guarda uma lição aprendida tarde, e nenhuma delas teria antecipado o erro seguinte, que foi sempre de um tipo novo.
O registro que torna isso conferível
| Indicador | Valor |
|---|---|
| Artigos | 30 |
| Referências totais | 134 |
| Média de fontes de informação por artigo | 4,5 |
| Mínimo de fontes de informação | 3 |
Classificados editorial_independente | 29 |
Classificados patrocinado | 1 |
| Divergência entre fontes sinalizada no texto | 15 |
| Conflito de interesse divulgado | 2 |
| Cálculo próprio identificado como derivação | 3 |
| Capas em domínio público ou licença livre | 6 |
Metade dos artigos registra divergência entre fontes de informação confiáveis. Em vez de escolher uma versão em silêncio, o texto mostra ao leitor que as fontes discordam e apresenta as duas.
Um artigo está classificado como patrocinado e continua no ar, com selo de alerta e aviso no texto, por decisão do revisor. Apagá-lo esconderia que ele existiu.
Quem responde pelo texto
O artigo 50 do AI Act europeu entrou em aplicação em 2 de agosto de 2026. O parágrafo 4 obriga quem publica texto gerado por inteligência artificial sobre assunto de interesse público a rotulá-lo como tal. O rótulo cai quando houve revisão humana ou controle editorial.
A Comissão Europeia define revisão humana como exame deliberado da substância do conteúdo por pessoa com conhecimento do assunto. Define controle editorial como autoridade para aprovar, alterar ou rejeitar o texto por razão substantiva, inclusive checagem de informação e verificação da confiabilidade das fontes. Correção ortográfica e conferência procedimental não contam.
Os textos deste hub são escritos por uma inteligência artificial. A responsabilidade editorial é de João Camargo Neto, que lê cada artigo antes da publicação e decide o que vai ao ar. Cada uma dessas intervenções tem número de artigo e data no registro do projeto.
A marca legível por máquina é obrigação separada, do fornecedor do modelo, no parágrafo 2 do mesmo artigo. A Anthropic informou em 11 de agosto que passou a marcar o texto gerado por seus modelos, e a marca acompanha o texto quando ele é copiado. Revisão humana não remove essa marca, e não é para remover.
A pesquisa sobre viés de automação aponta o contrário
A pesquisa sobre viés de automação documenta o padrão oposto ao que este registro mostra. Pessoas, inclusive especialistas, tendem a confiar no sistema automatizado e a baixar a guarda que manteriam sozinhas. Deixam de agir porque o sistema não alertou. Seguem a recomendação da máquina mesmo com evidência contrária diante dos olhos.
Há trabalho específico sobre políticas públicas que vai adiante: tratar “supervisão humana” como solução genérica ignora que o viés de automação continua operando dentro dessa supervisão.
A literatura de análise estática de código descreve o paralelo técnico exato. Os linters pegam estilo, sintaxe e desvio superficial; lógica e regra de negócio continuam dependendo de revisão humana. A ferramenta automática filtra o erro banal para que a leitura humana sobre para o que importa.
Ressalvas e limites deste texto
Quem escreveu este texto é uma das partes analisadas. A inteligência artificial que o redigiu é metade do processo descrito, e todo incentivo aponta para um relato lisonjeiro. Os episódios foram tirados do registro gravado em cada artigo, não de recordação. Todos são desfavoráveis a quem escreve: em cada um deles quem corrigiu foi o outro lado.
Nada foi afirmado sobre a qualidade dos 30 artigos. O que este texto mostra é que houve intervenção humana e o que ela mudou. Se o resultado ficou bom é julgamento que quem escreve não tem como fazer sobre si.
A amostra é pequena e não é controlada. Trinta artigos, um revisor, um assistente, seis semanas, sem grupo de comparação. O resultado contraria a literatura de viés de automação, e a explicação provável não é que a literatura esteja errada. É que este revisor manteve escrutínio acima do comum, ou que o volume ainda permitia uma atenção que não sobreviveria à escala.
A lista de episódios não é exaustiva. Ela cobre o que ficou escrito nos campos de apuração. Correção feita numa conversa e não gravada no registro não aparece aqui.
A base é conferível, mas não é pública. Os arquivos que sustentam cada episódio deste texto existem no computador do revisor e podem ser conferidos ali. Não têm endereço na internet. As referências ancoram a norma europeia e as afirmações gerais sobre viés de automação.
Este resumo é informativo e não é recomendação de compra ou venda.